企業・開発者のための ローカルLLM向けAI PC

AIを、自社の設備に。ローカルLLM向けAI PC

社内文書の分析、帳票の読み取り、不審なアクセスの監視。外部のAIサービスに機密情報を送らず、自社のパソコンでAIを動かす。使いたいモデルと業務に合わせて選べる、ローカルLLM向けBTOパソコンをご紹介します。

小さなモデルを試す8GBから、業務導入の主力となる16GB、本格運用の32GB、大容量メモリ搭載ワークステーションまで。必要な性能に応じてお選びください。

RECOMMENDED

まずは、用途に合った1台から。

ローカルLLMは、GPUの性能だけでなく、AIモデルを格納するVRAM容量が重要です。用途に合わせて、最初に比較したい3つの構成を選びました。

導入向け / VRAM 16GB
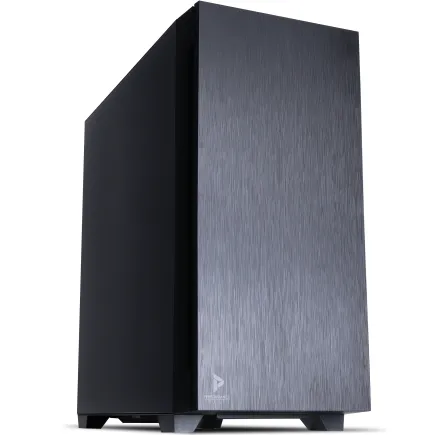
VRAM 16GBGeForce RTX 5060 Ti 16GB

Brainus Enterprise 184

CPU
Ryzen 7 9700X
メモリ
32GB DDR5-5600
SSD
1TB SSD
OS
OSなし
向いている方
書類の読み取りやログ分析など、社内AIを小さく始めたい企業
想定するAIモデル
Qwen3.5-9B(4〜8bit量子化)
このGPU・VRAMを選ぶ理由
モデル本体は4bitで約5.7GB、8bitでも約9.5GB。16GBなら、文章処理や画像入力に使うメモリの余裕も残せます。

461,780円税込

24回払い 月々19,240円(手数料0円)

  • 出荷目安 1〜4営業日
  • 送料無料
  • 1年間の無償修理保証

本格運用 / VRAM 32GB

VRAM 32GBRadeon AI PRO R9700

Brainus Advanced 145

CPU
Ryzen 9 9900X
メモリ
64GB DDR5-5600
SSD
2TB SSD
OS
OSなし
向いている方
27Bクラスのモデルで、文書・画像の分析や開発支援まで行いたい方
想定するAIモデル
Qwen3.8-27B(4bit量子化)
このGPU・VRAMを選ぶ理由
27Bの4bit量子化はモデル本体だけで約16.5GB。16GBのGPUには収まらないため、32GBが現実的な選択肢です。当社の社内AIも32GBのGPUで動かしています。

907,280円税込

24回払い 月々37,803円(手数料0円)

  • 出荷目安 1〜4営業日
  • 送料無料
  • 1年間の無償修理保証

大容量・拡張向け

VRAM 32GBGeForce RTX 5090

Brainus Advanced 105

CPU
Ryzen 9 9950X
メモリ
128GB DDR5-5600
SSD
2TB SSD
OS
OSなし
向いている方
大きなモデルの検証や、複数業務の並列処理まで視野に入れる方
想定するAIモデル
27Bクラスに加え、Qwen3.8-Flash-Nextなど大型モデルの検証
このGPU・VRAMを選ぶ理由
GPUに収まらない部分をシステムメモリへ置けるよう、メモリ128GB以上を搭載。扱えるモデルは広がりますが、GPUだけで動かすより速度は下がります。

2,184,380円税込

24回払い 月々91,015円(手数料0円)

  • 出荷目安 1〜4営業日
  • 送料無料
  • 1年間の無償修理保証

価格・構成は2026年11月10日時点の販売中モデルから表示しています。保証は到着後1年間のセンドバック方式で、有料で3年間まで延長できます(修理・保証について)。

OS・AI実行環境について:OSなし構成では、購入後にOSや必要なドライバ、推論ソフトウェアなどの導入が必要です。WindowsやLinuxの利用予定、モデルの対応状況を確認してお選びください。Windows 11 Home / Proは、各商品のカスタマイズ画面でプレインストールを選べます。

どの構成を選ぶべきか迷ったら

利用したいAIモデル、社内での用途、同時利用人数、予算に応じて必要なPC構成は変わります。購入前に確認したい条件を整理し、用途に合ったBTO構成をご検討ください。

AI PCの構成・見積について相談する

OUR CASES

私たち自身も、社内でローカルLLMを使っています。

パソコンを販売するだけでなく、実際の社内業務でもAIを活用しています。どんな仕事を任せ、どんなところを人間が確認するのか。現場の使い方をご紹介します。

運用中 総務・人事社内AIチャット

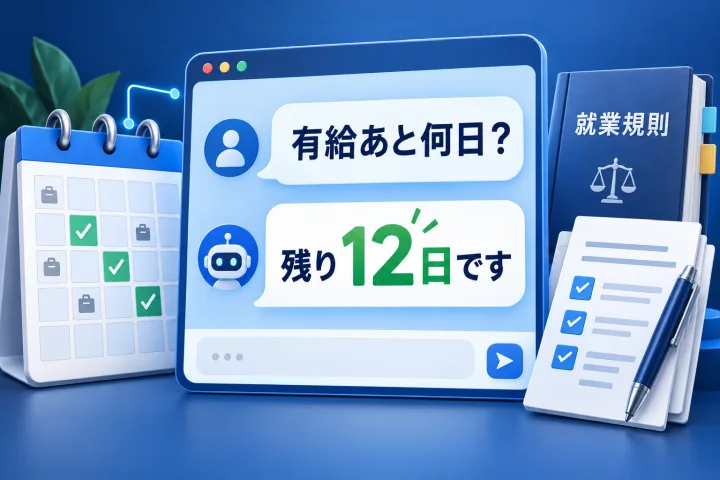
「有給あと何日?」に答える、社内総務AI

タイムカード・有給休暇の管理システムと連携して稼働中のAIチャット。勤怠や有給の確認、慶弔休暇など就業規則の案内、稟議書・申請書の下書きまでを手伝います。

  • 本人の勤怠・有給を確認して回答
  • 就業規則を根拠つきで案内
  • 稟議書・申請書の下書きを作成

推奨の入口:VRAM 16GB 読了 約10分

社内総務AIの事例を読む

取り組み中 経理画像読み取り

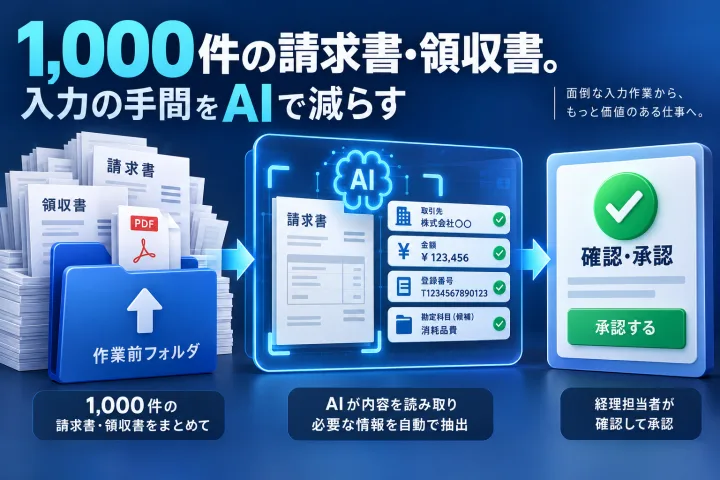
月1,000件の請求書・領収書。入力の手間をAIで減らす

請求書・領収書のスキャン画像から、取引先・金額・インボイス登録番号などを読み取り、勘定科目の候補まで作る仕組みを構築中。経理担当者が確認して承認する運用を目指しています。

  • 作業前フォルダに入れるだけ
  • 金額の整合性チェックと登録番号の照合を組み込む
  • 経理担当者が確認・承認

推奨の入口:VRAM 16GB 読了 約12分

経理書類の読み取り事例を読む

運用中 情報管理データベース監視

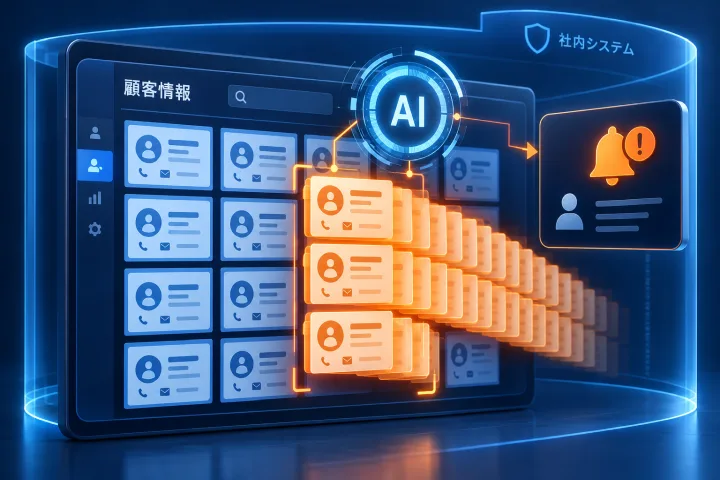
顧客情報の不自然な取得を、社内AIが知らせる

データベースの処理記録から、不自然な大量アクセスや危険なSQLを検出。普段と異なる個人情報の取得を見つけ、業務を止めずに管理者へ通知する仕組みを紹介します。

  • 3つの「いつもと違う」を分析
  • AIは止めずに管理者へ通知
  • 顧客情報の記録を社外に出さない

推奨の入口:VRAM 16GB 読了 約8分

DBログ監視の事例を読む

運用中 セキュリティログ監視

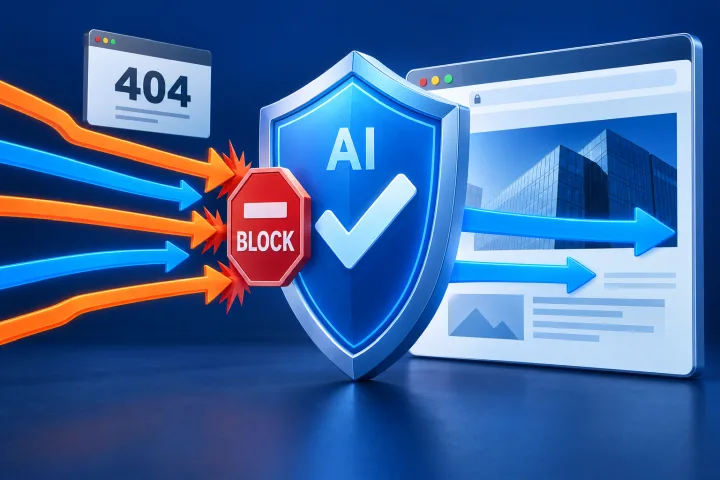
Webサイトへの攻撃を、AIが定期的に監視

Webサーバのログを5分ごとに収集し、不審なアクセスをAIが分析。設定したしきい値を超えたIPアドレスを7日間遮断する、当社の自動監視の仕組みを紹介します。

  • 5分ごとにログを分析
  • しきい値超えで7日間遮断
  • 404の裏の攻撃に気づけた

推奨の入口:VRAM 16GB 読了 約15分

Webログ監視の事例を読む

活用事例をすべて見る

AI PCを、社内の仕事につなぐ仕組み

  1. データを集める

    アクセスログ、データベースの処理記録、スキャンした請求書、社内の勤怠・規程

  2. プログラムで整理する

    AIに渡す必要な情報だけを取り出す

  3. 社内のAI PCが分析する

    異常の判定、内容の読み取り・分類、回答や下書きの作成

  4. 業務ごとに対処する

    • Webログ監視しきい値を判定し、条件を満たせば自動で遮断
    • DBログ監視異常を検出したら管理者へ通知(AIは止めない)
    • 経理・総務AIが内容を整理・下書きし、人が確認・承認(経理は取り組み中)

ログ監視は5分ごと、書類の読み取りは1日数回など、決めた間隔で自動実行。総務AIは社員の質問に応じて動きます。どの仕組みも、業務システムとつなぐプログラムが必要です。

データを集め、整理し、AIが分析するところまでは共通。最後の対処は、自動遮断・通知・人の承認と、業務によって分けています。

WHY LOCAL

機密情報を扱う仕事こそ、社内で動かすAIを。

ChatGPTやClaudeなどのクラウドAIには、高い性能と導入の手軽さがあります。一方、社内の機密情報を継続的に扱う仕事では、AIをどこで動かすかも重要な判断です。

  1. 社内の情報を、社内で分析

    顧客情報、契約書、仕入原価、システムログ。外部通信を制限した構成なら、こうした情報を外部AIサービスへ送信せずに処理できます。

  2. AIの利用量に応じたAPI課金がない

    毎日数百回のログ分析や、大量の帳票処理にも。導入費と電気代・保守費は必要ですが、推論ごとに外部サービスの従量料金は発生しません。

  3. 自社の仕事に合わせて組み込める

    既存の業務システムやデータベースとAPIで連携。監視、分類、抽出、通知などを自社の運用ルールに合わせて設計できます。

  4. 一台を複数部署で活用できる

    経理の書類読み取り、情シスのログ分析、総務の文書整理。用途を増やして、同じAI PCを使い続けられます。

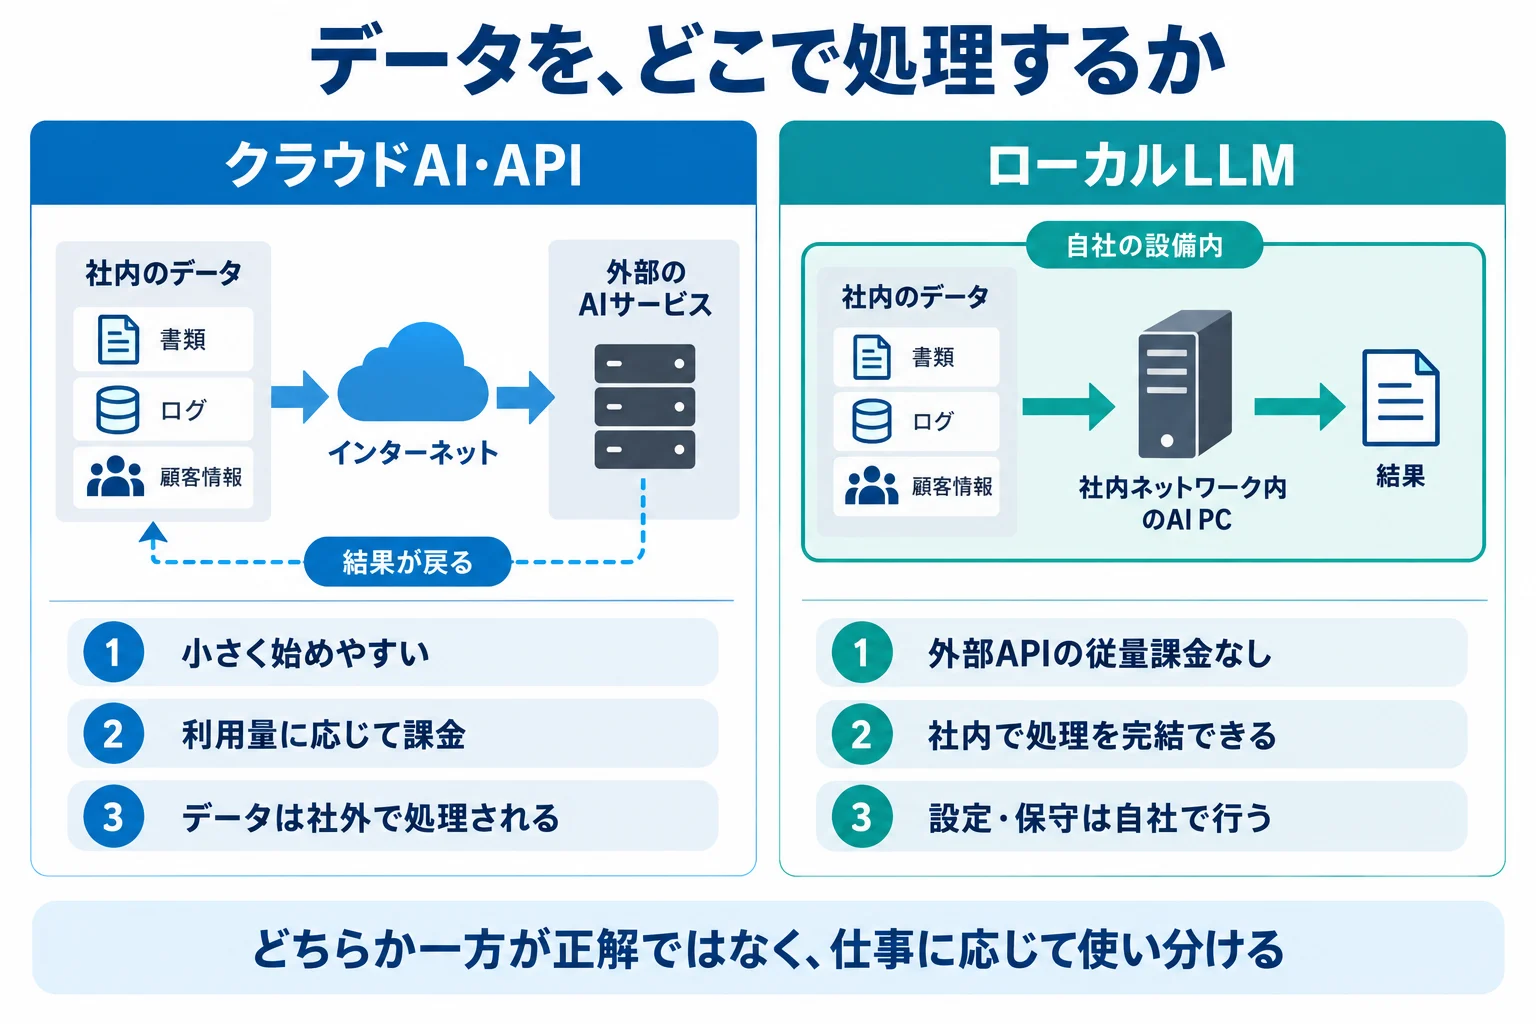
クラウドAIとローカルLLMの違いの図。クラウドAI・APIは、社内の書類・ログ・顧客情報をインターネット経由で外部のAIサービスに送り、結果が戻る。小さく始めやすく、利用量に応じて課金され、データは社外で処理される。ローカルLLMは、社内の同じデータを社内ネットワーク内のAI PCで処理し、自社の設備内で完結する。外部APIの従量課金はなく、設定・保守は自社で行う。どちらか一方が正解ではなく、仕事に応じて使い分ける。 拡大して見る
データを、どこで処理するか。クラウドAIとローカルLLMの違い
クラウドAI・APIとローカルLLMの比較
比較クラウドAI・APIローカルLLM
初期費用小さく始めやすいGPU搭載PC・環境構築が必要
利用コスト利用量・契約に応じて課金電力・保守・更新費、外部API従量課金なし
データの処理場所サービス事業者側自社設備内で完結できる
モデル性能高性能モデルを利用しやすい機器とモデルの性能・容量に制約
保守・運用サービス側に依存する部分が大きい自社で設定・監視・更新が必要

どちらか一方が常に正解というわけではありません。単発の高度な相談はクラウドAI、社内データを使った反復業務はローカルLLM。使い分けることで、性能・費用・情報管理のバランスを取りやすくなります。

VRAM GUIDE

何GBのGPUを選べば、使いたいAIを動かせる?

ローカルLLMでは、GPUメモリ(VRAM)がモデル選びの大きな基準になります。モデルの規模、量子化、処理する文章の長さ、画像入力の有無によって必要容量は変わります。

目安:9Bクラスで業務を始めるなら16GB、27Bクラスを本格的に動かすなら32GB。8GB・12GBは小型モデルの試用や個人の開発向けです。

VRAM容量とAIモデルの早見表(目安)
GPU VRAM主なGPU例AIモデルの選び方向いている用途商品
8GB RTX 5060 / RX 9060 XT 8GB Qwen3.5-2B・4Bの4bit量子化など 簡単な分類・抽出、入門・試験導入 商品を見る
12GB RTX 5070 Qwen3.5-9Bの4bit量子化など 個人開発、単一業務、試験導入 商品を見る
16GB RTX 5060 Ti 16GB / RTX 5070 Ti / RTX 5080 / RX 9060 XT 16GB / RX 9070 XT Qwen3.5-9Bの4〜8bit量子化など 社内チャット、帳票・画像処理、ログ分析 商品を見る
32GB RTX 5090 / Radeon AI PRO R9700 Qwen3.8-27Bの4〜6bit量子化など 本格的な文書・画像分析、開発、複数用途 商品を見る
大容量RAM 128〜256GB以上のRAM構成 モデルのCPUオフロード・大型モデル検証 大規模モデル、拡張・研究開発 商品を見る

「量子化」で、必要なメモリはここまで変わる

量子化は、AIモデルの数値データの精度を調整し、必要なメモリ容量を小さくする方法です。例えば、27Bクラスのモデルでも4bit量子化ならモデル本体が約16.5GBという配布例があります。ただし、実際に動かすには文章処理用のメモリ(KVキャッシュ)や、画像入力用の追加ファイル(約0.9GB)も必要です。

「VRAMに収まる」と「快適に使える」は別です。モデル本体がぎりぎり収まっても、長い文書を読ませたり、複数の人が同時に使ったりすると、メモリが足りずに速度が落ちたり、動かなくなったりします。

グラフは公開されているモデルファイル(GGUF)の容量で、当社の実測値ではありません。実際に使うVRAMと推奨VRAMは、AIモデル、量子化方式、コンテキスト長(一度に扱う文章の長さ)、画像入力の有無、推論エンジンによって変わります。

AIモデル本体の容量と、GPUメモリ(VRAM)の目盛り

9Bモデル4bit量子化(Q4_K_M系)

約5.7GB

27Bモデル4bit量子化(Q4_K_M系)

約16.5GB

9BモデルBF16(高精度)

約17.9GB

27BモデルBF16(高精度)

約54.7GB32GBを超える

参考資料・更新日

容量は2026年11月4日に確認した配布ファイルの値です。早見表の「AIモデルの選び方」は当社の目安で、生成速度は含みません。

LINEUP

VRAM容量から、ローカルLLM向けPCを選ぶ

動かしたいAIモデルが決まっているなら、VRAM容量から選ぶのが近道です。各容量帯の特徴を押さえて、必要な性能と予算に合った構成を探せます。

「OSなし」の構成は、購入後にOS・ドライバ・推論ソフトウェアの導入が必要です(OS・AI実行環境について)。

16GB業務導入の主力

VRAM 16GB|社内AIを、現実的な構成から。

ログ分析、社内チャット、請求書の画像読み取りなど、仕事で使うローカルLLMの導入に。9Bクラスの4bit量子化モデルを動かす余裕を確保しやすく、価格と用途のバランスを取りやすい容量です。

RTX 5060 Ti 16GBは導入費を重視する方に。RTX 5070 Ti・RTX 5080は処理速度を重視する方に。Radeon RX 9060 XT 16GB・RX 9070 XTは対応するソフトウェア環境を確認したうえで検討できます。

32GB27B級を本格運用

VRAM 32GB|大きなAIモデルを、余裕のあるGPUで。

Qwen3.8-27Bの4bit量子化をはじめ、モデルの品質や処理条件を調整しながら運用したい方へ。文書・画像の分析、開発支援、社内の複数業務への展開を見据えた構成です。

NVIDIA GeForce RTX 5090はCUDAを利用する開発環境で有力な選択肢。AMD Radeon AI PRO R9700は32GB VRAMを備え、ROCm等の対応環境で検討できます。用途と対応ソフトウェアを合わせて選んでください。

GPU別に全モデルを見る

12GB開発・検証

VRAM 12GB|小さく試し、使い方を確かめる。

9Bクラスの4bit量子化モデルを使った試験導入や、個人・少人数での開発に。必要な処理量が限られている場合の選択肢です。長い文書や同時利用を重視する場合は、16GB以上と比較してください。

GPU別に全モデルを見る

8GB小型モデルから

VRAM 8GB|小型モデルから始めるローカルAI。

文章の分類、短い文書の要約、定型データの抽出など、小型モデルで始められる仕事は少なくありません。初めての環境構築やAI学習向けに、購入しやすい構成をご案内します。

GPU別に全モデルを見る

IN-HOUSE

実際に動かしているから、選び方にも理由があります。

当社の社内AI環境では、Ryzen 7 9800X3D、GeForce RTX 5090(VRAM 32GB)、メモリ192GBのPCを使用しています。Qwen3.8-27Bの4bit量子化を利用し、ログ分析など社内業務への活用を進めています。用途に応じたモデル選び、メモリ容量、運用方法を実際に試しながら構成を検討しています。

32GB VRAM搭載モデルを見る

パソコンショップSEVEN 社内AI環境の構成
CPUAMD Ryzen 7 9800X3D
GPUGeForce RTX 5090
VRAM32GB
システムメモリ192GB
AIモデルQwen3.8-27B
量子化4bit(Q4_K_M系)
主な用途Webログ監視・DBログ監視・社内業務の分析

SCALE UP

大規模なモデルや拡張性を求めるなら。

AIモデルは必ずしもすべてをGPUメモリに置く必要はありません。システムメモリへのオフロードや複数GPUを使う方法もあります。ただし、処理速度や対応ソフトウェアには違いがあります。

128GB・192GB・256GB以上の大容量RAM

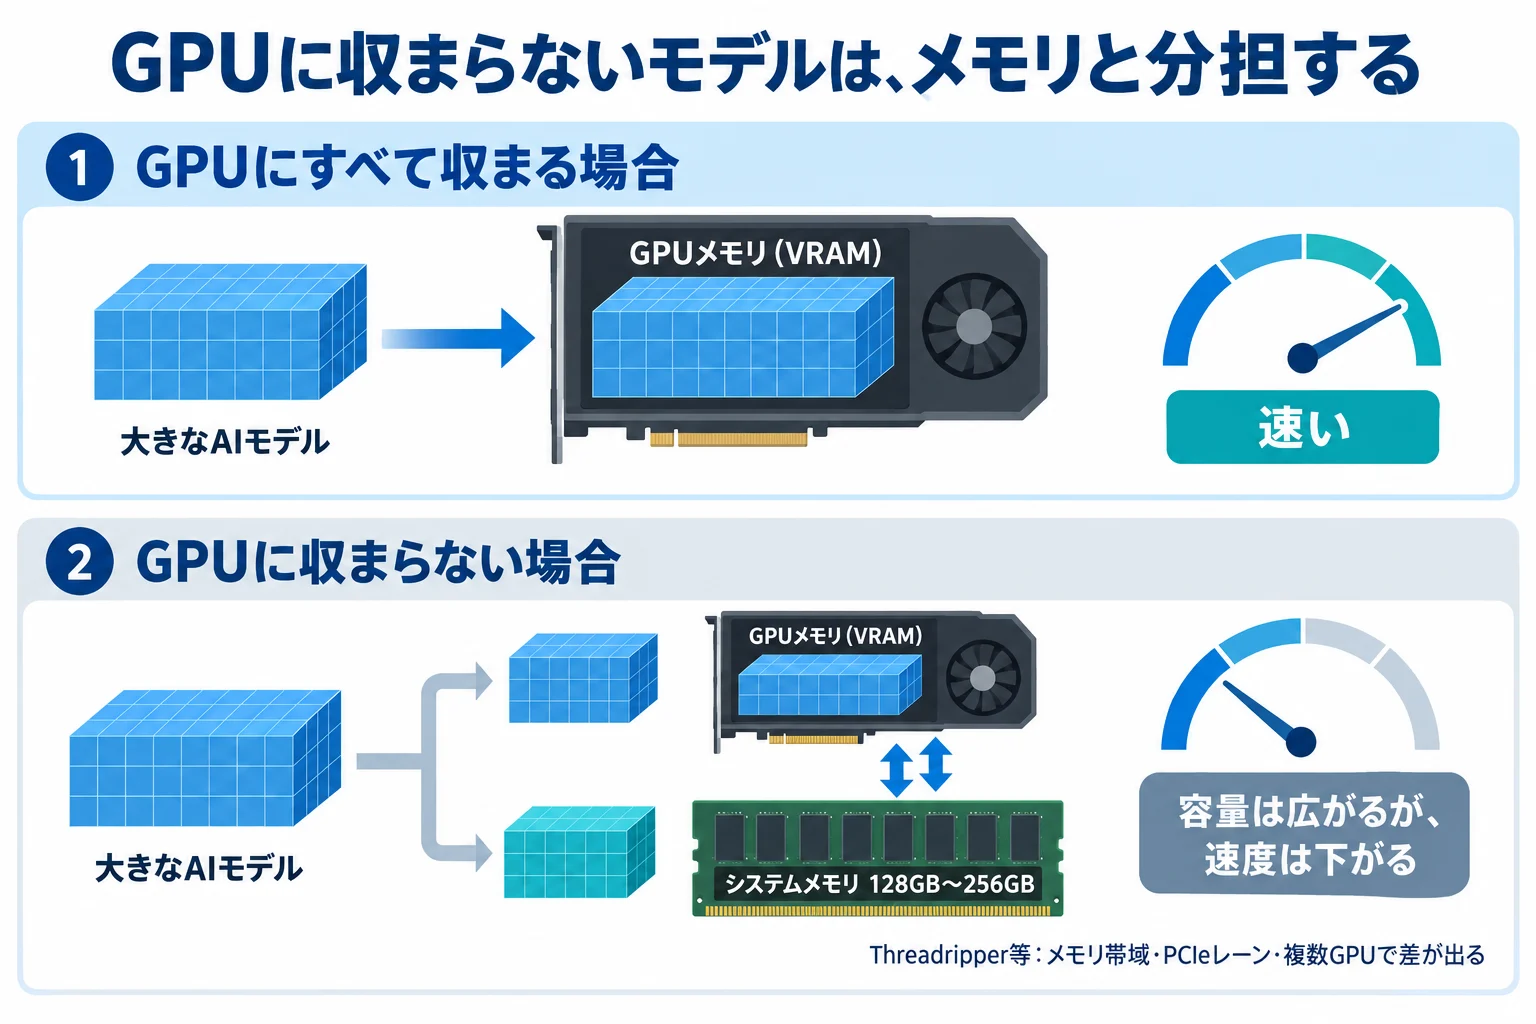
GPUに収まりきらないモデルの一部をシステムメモリ側に置き、大型モデルを試すための構成です。メモリ容量を増やせば扱えるモデルの選択肢は広がりますが、GPUに収めた場合と同じ速度になるわけではありません。用途に応じて容量と処理速度を見極めます。

Qwen3.8-Flash-Nextのように、モデルの構造上、システムメモリへのオフロードが重要になるケースもあります。4bit量子化(Q4_K_M)の配布ファイルだけで約120GB(bartowski/Qwen3.8-Flash-Next-GGUF、2026年11月4日確認)。こうした大型モデルは、容量だけでなく推論エンジンとハードウェア構成の確認が必要です。

GPUに収まらないモデルはメモリと分担する、という図。上段:GPUにすべて収まる場合は、AIモデル全体がGPUメモリ(VRAM)に入り、速い。下段:GPUに収まらない場合は、モデルの一部をGPUメモリに、残りをシステムメモリ128GB〜256GBに置き、両者でやり取りする。容量は広がるが、速度は下がる。Threadripper等では、メモリ帯域・PCIeレーン・複数GPUで差が出る。 拡大して見る
GPUに収まらない分をシステムメモリへ。容量は広がるが、速度とのバランスが必要です。

メモリ128GB搭載の販売中モデル

大容量メモリ搭載PCを見る(49機種)

Threadripperが必要になるのは、どんなときか。

AIモデル全体を1枚のGPUへ載せて動かすだけなら、CPUを高価なものに変えても大きな速度差が出ない場合があります。Threadripperが真価を発揮するのは、大容量メモリを使う処理、CPU側へのオフロード、複数GPU、高速ストレージなどを組み合わせた環境です。

Threadripperが必要になる構成と理由
構成理由
CPUオフロードCPU性能とメモリ帯域の影響が大きくなる
複数GPU搭載PCIeレーン・筐体・電源・冷却の余裕が必要
大容量ECCメモリ対応プラットフォーム・RDIMM・拡張性を重視
データ前処理・RAG構築並列CPU処理・ストレージI/Oを利用

CHECK POINTS

購入前に確認したい、AI PCの実行環境。

同じVRAM容量でも、使いたいAIソフトウェアによって適したGPUは変わります。NVIDIAはCUDAを利用する開発環境の選択肢が豊富。AMDはROCmやVulkanなど対応する実行環境を確認して選びます。OSや推論エンジンも含めて検討してください。

GPU

VRAM容量だけでなくソフトウェア対応も

RTX 5090とRadeon AI PRO R9700はどちらも32GBですが、使えるバックエンドや導入手順は同じではありません。CUDAを前提とする場合はNVIDIAを選びます。

OS

使い方に合わせてWindows / Linuxを選ぶ

個人の検証環境ならWindows、社内システムとのAPI連携や常時運用ならUbuntuなどのLinuxも選択肢です。使うツールの対応状況で決めます。

運用

AI PCの購入と業務システムの構築は別

AIモデルの導入、APIの設定、社内ネットワークの認証、監視・バックアップなど、用途に応じた設定が必要です。製品に含まれるサービス範囲をご確認ください。

GPUの仕様は各社の公式ページをご確認ください:NVIDIA GeForce RTX 50シリーズ、AMD Radeon AI PRO R9700、AMD Radeon グラフィックス

調達チェックリスト

  • VRAM
  • RAM
  • GPU互換性
  • OS
  • 電源・冷却
  • ストレージ
  • 長時間運用の保証条件
  • モデル導入範囲
  • 納期・見積

どの構成を選ぶべきか迷ったら

利用したいAIモデル、社内での用途、同時利用人数、予算に応じて必要なPC構成は変わります。購入前に確認したい条件を整理し、用途に合ったBTO構成をご検討ください。

AI PCの構成・見積について相談する

COST

AI PCは、いくらで導入して、どれだけ使えるのか。

買い切りのAI PCには購入費と初期設定費がかかります。一方、ローカル推論には外部AI APIの従量料金がありません。毎日繰り返す仕事をどれだけ任せられるかで、費用の見え方が変わります。

条件を変えて試算する(モデルケース)

円
円
時間
円
円
初期費用
600,000円
月間人件費換算効果
62,500円
月間純効果(維持費を引いた額)
51,500円
初期投資の回収目安
約11.7か月
  • 初期費用 = AI PC購入費 + 初期構築費
  • 月間人件費換算効果 = 月間削減時間 × 時間あたりの人件費換算
  • 月間純効果 = 月間人件費換算効果 − 月額電気代・保守費
  • 回収目安 = 初期費用 ÷ 月間純効果
累積の効果から初期費用を引いた額(入力に合わせて変わります)
経過月数ごとの「累積の月間純効果 − 初期費用」。プラスになった時点で初期費用に相当する効果が出たことになります。
12か月後24か月後36か月後
+18,000円+636,000円+1,254,000円

これは、従来の作業が実際に減った場合の試算です。作業時間が減っても給与支出が同額減るとは限りません。監視を新設する場合は「人件費削減」ではなく「今までできなかった監視を実現する設備投資」として評価します。

FAQ

ローカルLLM向けPCのよくある質問

ローカルLLMにはGPUが必要ですか?

CPUだけでも動作させられるモデルはあります。ただし、実用的な速度で文章や画像を処理するには、対応するGPUを使う構成が有力です。

VRAM 8GBでもAIを動かせますか?

小型モデルの4bit量子化などが候補になります。長い文章や大規模モデル、複数同時利用には余裕が少ないため、用途に合わせて選びます。

VRAM 16GBと32GB、どちらを選ぶべきですか?

9Bクラスを中心とした業務導入なら16GBが一つの目安。27BクラスをGPU上で動かし、量子化や入力条件の選択肢を広げたい場合は32GBを検討してください。

システムメモリを増やせばVRAMの代わりになりますか?

モデルの一部をRAMへ置いて処理する方法はありますが、GPUメモリと同じ速度にはなりません。大規模モデルを扱う選択肢は増えますが、速度との兼ね合いを考える必要があります。

NVIDIAとAMDのGPUは何が違いますか?

ローカルLLMの実行に使うソフトウェア環境が異なります。CUDAを利用する場合はNVIDIA、ROCmなどAMD対応環境ではRadeonも選択肢になります。利用予定のモデルと推論エンジンを事前に確認してください。

画像やPDFも読み取れますか?

画像入力に対応したモデルなら、スキャン書類や画像を分析できます。画像対応の推論エンジンと、必要な追加ファイル・設定が揃っていることが条件です。

インターネットにつながずに使えますか?

モデル・ソフトウェアを事前に取得し、必要な設定を済ませれば、社内ネットワークに閉じた運用も可能です。更新や外部情報の取得を行う場合は別途通信設計が必要です。

AI PCを購入したら、すぐ社内の仕事が自動化されますか?

AIモデルのインストールだけで業務連携が完成するわけではありません。帳票読み取り、ログ監視、通知などには、既存システムと接続する仕組みが必要です。

用途が決まったら、必要なVRAMから選ぶ。

はじめての社内AIから、大規模モデルの運用・開発まで。必要な性能を見極めて、構成を選べるBTOパソコンをご用意しています。

パソコンショップSEVENは、BTOパソコンの構成選びから製造・出荷まで、自社で取り組んできました。AIを仕事で使うための一台も、用途と構成を確かめながらお選びいただけます。

AI PCを探す